Analyse de données de protéomique : affinité et spectrométrie de masse
Protéomique d’affinité ou spectrométrie de masse non ciblée : Sycomia analyse vos données de protéomique pour identifier des biomarqueurs, comprendre les fonctions des protéines et les relier à vos autres données omiques. Nous traitons notamment les données Olink®, SomaScan® et d’immunodosages.
Protéomique d’affinité
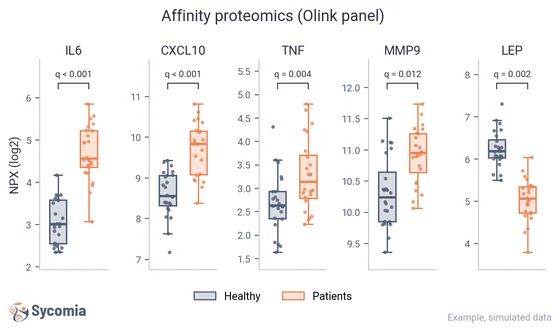
La protéomique d’affinité mesure un panel de protéines choisies à l’avance, souvent dans le sang, à l’aide d’anticorps ou d’aptamères, avec une grande sensibilité. Les plateformes Olink et SomaScan mesurent les niveaux relatifs de centaines à des milliers de protéines pour rechercher ou valider des biomarqueurs.
Exemples d’analyses
- Olink PEADonnées Olink sur des panels comme Target 96, Explore HT et Reveal : contrôle qualité, bridging entre plaques ou entre lots, gestion des valeurs sous la limite de détection, puis analyse différentielle.
- SomaScanJusqu’à 11 000 protéines : normalisation, contrôle qualité, annotation des aptamères et analyse différentielle.
- Immunodosages multiplexésDonnées Luminex et MSD : ajustement des courbes standard (4PL, 5PL), gestion des limites de quantification et des effets plaque, comparaison entre groupes.
- Signatures de biomarqueursSélection de protéines, modèles prédictifs, courbes ROC et validation croisée.
Spectrométrie de masse non ciblée
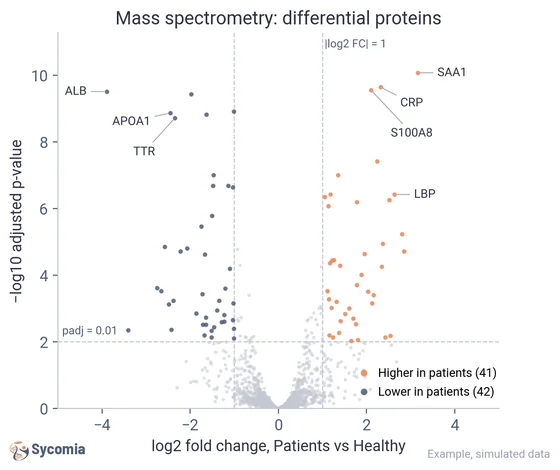
La spectrométrie de masse non ciblée identifie et quantifie les protéines présentes dans un échantillon, sans liste définie à l’avance. Elle donne une vue large du protéome pour découvrir les protéines qui changent entre vos conditions.
Exemples d’analyses
- Identification des protéines et peptidesRecherche en bases protéiques (UniProt) sur données DDA ou DIA, avec un taux de fausses découvertes contrôlé à 1 % au niveau des peptides et des protéines.
- QuantificationQuantification sans marquage (LFQ, DIA) ou par marquage isobare (TMT), avec normalisation entre échantillons et entre lots.
- Valeurs manquantesLe défi propre à la spectrométrie de masse : filtrage et imputation adaptés selon que les valeurs manquent au hasard ou à cause d’une faible abondance.
- Abondance différentielleVariations significatives d’abondance entre conditions, avec contrôle du taux de fausses découvertes (FDR), pour la découverte de biomarqueurs et pour orienter l’interprétation biologique.
Analyse fonctionnelle des protéines
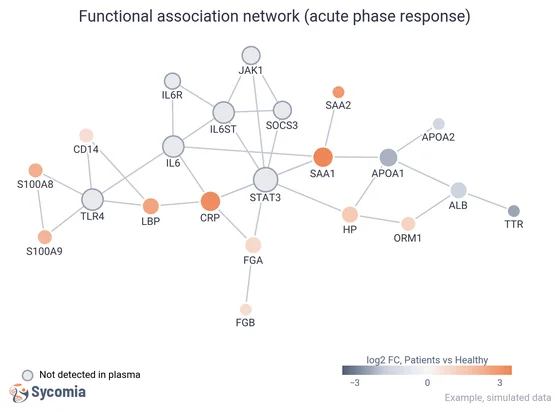
L’analyse fonctionnelle replace les protéines dans leur contexte : avec quelles autres protéines elles sont associées, quels domaines elles portent, dans quelles voies biologiques elles agissent.
Exemples d’analyses
- Réseaux d’associationRéseaux d’interactions et d’associations fonctionnelles issus de bases de référence comme STRING, pour mettre vos protéines en contexte et identifier les modules et les protéines centrales.
- Modules différentielsVariations d’abondance projetées sur le réseau, pour repérer les groupes de protéines associées qui changent ensemble entre vos conditions.
- Domaines et motifsAnnotation des domaines et motifs protéiques, pour éclairer la fonction, la structure et les capacités d’interaction.
- Enrichissement fonctionnelAnalyses d’enrichissement GO et KEGG, avec le protéome détecté comme univers de référence, pour mettre en évidence les voies et processus biologiques représentés dans vos données.
Intégration multi-omique
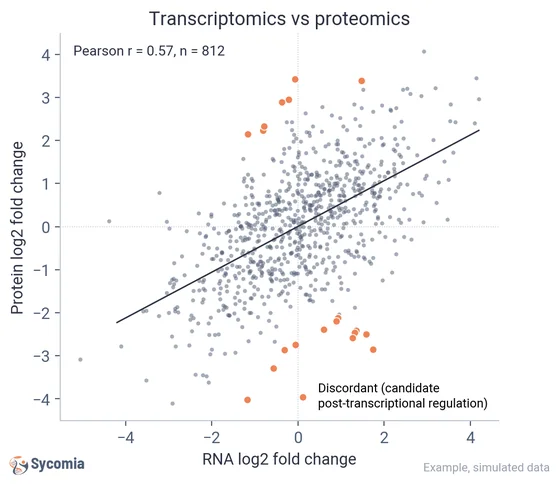
L’ARN et les protéines ne varient pas toujours ensemble. Croiser protéomique et transcriptomique met en évidence des discordances évocatrices de régulations post-transcriptionnelles, et renforce la découverte de biomarqueurs.
Exemples d’analyses
- Protéomique et transcriptomiqueCorrélation entre les variations des protéines et celles des ARN, pour repérer les discordances évocatrices de régulations post-transcriptionnelles.
- Analyse conjointe des voiesVoies biologiques analysées en combinant les signaux ARN et protéines, pour orienter l’interprétation biologique.
- Intégration multi-couchesFacteurs latents et signatures combinées, pour relier plusieurs omiques mesurées sur les mêmes échantillons.
- Stratification des échantillonsClassification et découverte de sous-groupes d’échantillons à partir de données multi-omiques, par clustering et apprentissage automatique.
Votre analyse n’est pas dans la liste ? Nous construisons aussi des analyses sur mesure, adaptées à votre question biologique. Parlons-en
Questions fréquentes
Une autre question sur votre projet ? Écrivez-nous, un expert vous répond.
Nous contacterQuelles technologies de protéomique prenez-vous en charge ?
Les plateformes d’affinité comme Olink (Target 96, Explore HT, Reveal) et SomaScan, les immunodosages multiplexés, et la spectrométrie de masse non ciblée.
Pouvez-vous combiner nos données de protéomique et de transcriptomique ?
Oui. Nous corrélons l’abondance des protéines à l’expression des ARN et inférons les voies et réseaux impliqués, pour une vision à plusieurs niveaux de votre biologie.
Les données de protéomique permettent-elles de classer des échantillons ?
Oui. Nous appliquons l’apprentissage automatique pour stratifier les échantillons, découvrir des sous-groupes et construire des modèles de classification.
Mes données restent-elles confidentielles ?
Oui. Nous signons un NDA sur simple demande, avant tout échange de données. Vos données sont traitées sur nos propres serveurs, les données cliniques sont hébergées en France chez un hébergeur de données de santé certifié (HDS), et vos données sont effacées dans les 30 jours suivant la fin du projet, ou plus tôt à votre demande, conformément au RGPD.
Services associés
Parlons de votre projet de protéomique
Ciblée ou spectrométrie de masse : parlez-nous de votre question biologique et de vos données, nous vous proposerons la bonne stratégie d’analyse.