Analyse de données de génomique : des variants aux génomes complets
Détection de variants, biopsie liquide, assemblage de génomes et génomique comparative : Sycomia analyse vos données de séquençage ADN de bout en bout, avec une stratégie construite autour de votre question biologique.
Analyse de variants
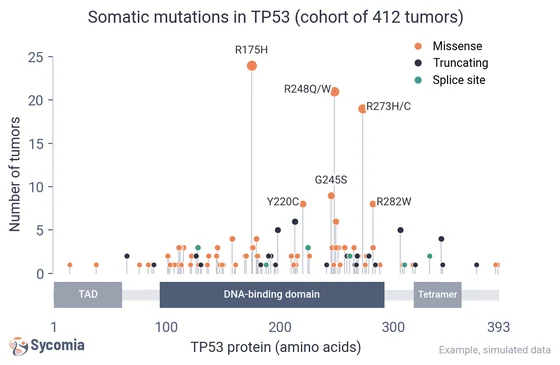
Le séquençage du génome complet (WGS) ou de l’exome (WES) lit l’ADN d’un individu ou d’une tumeur. L’analyse de variants repère les différences par rapport au génome de référence, des mutations ponctuelles aux variants structurels, puis les annote pour identifier celles qui ont un effet biologique ou clinique.
Exemples d’analyses
- Détection de variants germinaux et somatiquesSNV, indels, variations du nombre de copies et variants structurels détectés à partir de données de génome ou d’exome complet, livrés sous forme de jeux de variants annotés et filtrés, prêts pour l’interprétation en recherche et en recherche clinique.
- Annotation et priorisationClassement des variants selon leur impact fonctionnel, leur fréquence dans la population (gnomAD), leur signification clinique (ClinVar) et leur pathogénicité prédite, pour cibler les mutations pertinentes.
- GWAS et fine-mappingAnalyse statistique de grandes cohortes pour identifier les variants associés à des caractères ou des maladies, et prioriser ceux à impact fonctionnel probable.
- Signatures mutationnellesExtraction et interprétation des signatures fondées sur le contexte trinucléotidique des mutations somatiques, pour révéler les processus mutagènes en jeu.
- Génomique des populationsAnalyse de la variation génétique entre populations pour décrire leur structure, leur diversité et leur histoire évolutive.
ADN tumoral circulant et biopsie liquide
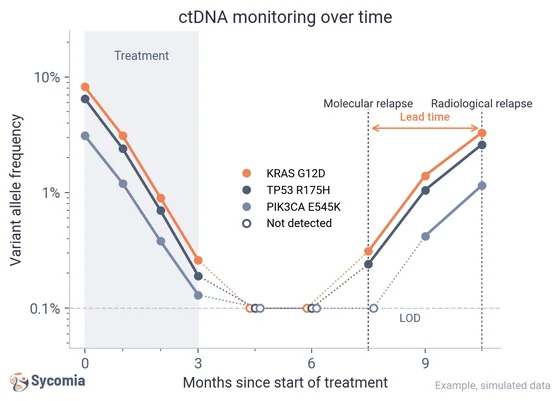
La biopsie liquide analyse l’ADN libre circulant dans le sang, dont les fragments libérés par la tumeur (ctDNA). Avec un séquençage très profond et des identifiants moléculaires uniques, on détecte des mutations présentes en très faible proportion et on suit leur évolution pendant et après le traitement.
Exemples d’analyses
- Séquençage ultra-profond avec UMILes identifiants moléculaires uniques regroupent les lectures issues de chaque molécule d’ADN d’origine pour corriger les erreurs de séquençage, et détecter avec une grande sensibilité les mutations rares à faible fréquence allélique.
- Suivi guidé par la tumeurLes mutations identifiées dans la tumeur sont suivies dans les prélèvements sanguins successifs, pour détecter la maladie résiduelle et la rechute moléculaire avant qu’elle ne soit visible à l’imagerie.
- Fraction tumoraleQuantification de la part d’ADN d’origine tumorale dans l’ADN circulant, pour suivre la charge de la maladie pendant et après le traitement.
- Un pipeline multi-plateformes en développementNotre projet de recherche combine Illumina, Oxford Nanopore et PacBio, avec des modèles d’IA qui fusionnent les signaux génomiques et épigénomiques portés par les lectures longues. Découvrir nos recherches.
Assemblage et annotation de génomes
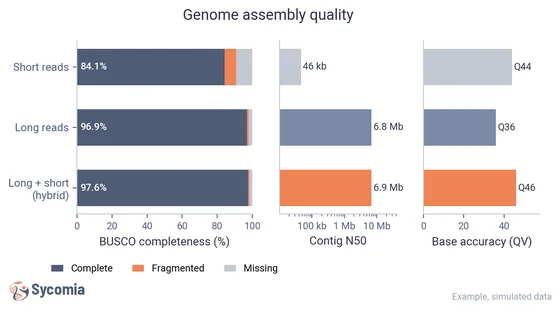
Quand aucun génome de référence n’existe, ou pour étudier une souche précise, on reconstruit le génome à partir des lectures de séquençage. Les lectures longues traversent les régions répétées et donnent des assemblages bien plus continus, et des lectures courtes peuvent s’y ajouter pour corriger les erreurs de bases. Le génome est ensuite annoté pour localiser les gènes et leurs fonctions.
Exemples d’analyses
- Assemblage de novo (lectures courtes, longues ou hybride)Des génomes reconstruits à partir de zéro avec des pipelines adaptés à votre organisme et à vos données, y compris pour les espèces non modèles : lectures longues pour la continuité, lectures courtes pour corriger les erreurs si besoin.
- Contrôle qualité de l’assemblageComplétude en gènes (BUSCO), justesse des bases (Merqury QV), contiguïté et détection des contaminations, pour savoir jusqu’où se fier à chaque assemblage.
- Assemblage résolu par haplotypeAssemblage séparé des deux copies de chaque chromosome, à partir des données parentales (trio) ou de Hi-C, pour étudier la variation propre à chaque allèle et l’hérédité.
- Annotation de génomesMasquage des répétitions, prédiction des gènes appuyée par des données RNA-seq, et annotation fonctionnelle (termes GO, voies KEGG).
Génomique comparative
La génomique comparative met plusieurs génomes côte à côte pour comprendre ce qui les rapproche et les distingue : gènes partagés ou propres à une espèce ou à une souche, réarrangements, histoire évolutive.
Exemples d’analyses
- Orthologues et paraloguesIdentification précise des gènes orthologues et paralogues pour étudier l’évolution des gènes et la conservation des fonctions.
- Synténie et réarrangementsAnalyse de l’ordre conservé des gènes et détection des inversions, translocations et duplications entre génomes.
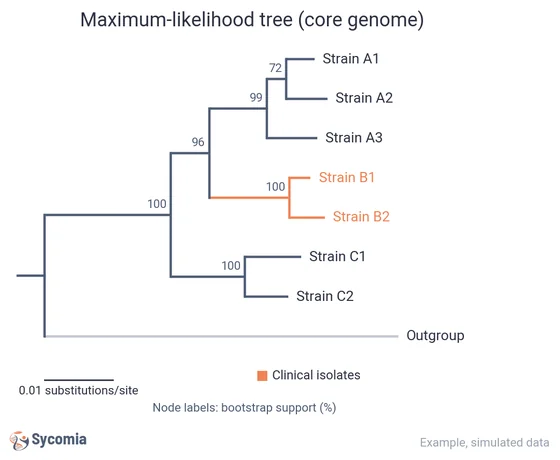
- PhylogénomiqueArbres phylogénétiques construits à partir de nombreux gènes ou de génomes entiers, pour retracer l’histoire évolutive des espèces ou des populations.
- Pan-génomeGènes communs et gènes accessoires des génomes d’une espèce, pour révéler ce que partagent toutes les souches et ce qui les distingue.
Votre analyse n’est pas dans la liste ? Nous construisons aussi des analyses sur mesure, adaptées à votre question biologique. Parlons-en
Questions fréquentes
Une autre question sur votre projet ? Écrivez-nous, un expert vous répond.
Nous contacterAnalysez-vous les données de génome et d’exome complets ?
Oui. Nous traitons les données WGS et WES avec un pipeline validé de détection de variants, puis nous annotons et priorisons les variants selon votre question.
Travaillez-vous avec le séquençage en lectures longues ?
Oui. Les lectures longues sont particulièrement utiles pour l’assemblage de génomes, seules ou combinées aux lectures courtes en assemblage hybride, et pour les régions complexes.
Pouvez-vous travailler sur des organismes non modèles ?
Oui. Nous assemblons et annotons des génomes de novo, y compris pour des espèces peu étudiées, et les comparons aux génomes apparentés.
Mes données restent-elles confidentielles ?
Oui. Nous signons un NDA sur simple demande, avant tout échange de données. Vos données sont traitées sur nos propres serveurs, les données cliniques sont hébergées en France chez un hébergeur de données de santé certifié (HDS), et vos données sont effacées dans les 30 jours suivant la fin du projet, ou plus tôt à votre demande, conformément au RGPD.
Services associés
Parlons de votre projet de génomique
Variants, ADN tumoral circulant, assemblage ou génomique comparative : parlez-nous de votre question biologique et de vos données, nous vous proposerons la bonne stratégie d’analyse.