L’intelligence artificielle au service de vos données biologiques
Pour la santé, la recherche et l’agroalimentaire, Sycomia associe l’expertise bioinformatique à l’apprentissage automatique et au deep learning pour analyser des données biologiques complexes, et conçoit, développe et entraîne des modèles adaptés à vos questions.
- machine learning
- deep learning
- LLM
- modèles de fondation
- fine-tuning
- interprétabilité
// 01 Questions
Les questions auxquelles l’IA peut répondre
L’intelligence artificielle prend le relais quand une question biologique dépasse la portée d’une analyse classique. Quelques exemples :
-
Q.01 Stratification
Existe-t-il des sous-groupes distincts de patients ?
Nous recherchons, sans a priori, des sous-groupes de patients dans vos données omiques (ADN, ARN, protéines) et cliniques, puis caractérisons ce qui les distingue.
-
Q.02 Biomarqueurs
Quelle signature distingue mes groupes ?
Nous identifions des signatures moléculaires robustes liées à une maladie, un traitement ou un phénotype, y compris pour la sélection agronomique.
-
Q.03 Annotation
Que fait cette séquence ?
Nous prédisons l’annotation structurale et fonctionnelle de séquences génomiques et protéiques : gènes, structure, sites fonctionnels.
-
Q.04 Prédiction
Peut-on prédire la réponse au traitement ou un autre résultat ?
Nous développons des modèles de prédiction et de classification sur mesure, à partir de données omiques, cliniques ou contextuelles, et les évaluons sur des données indépendantes.
-
Q.05 Variants
Cette mutation a-t-elle un effet ?
Nous estimons l’impact d’une mutation sur l’activité d’un gène ou la stabilité d’une protéine, et ses conséquences possibles.
Votre projet ne rentre pas dans ces cases ? Nous concevons aussi des modèles sur mesure pour votre question. Parlons-en
// 02 Modèles de fondation
LLM et modèles de fondation
Entraînés sur des millions de séquences, de cellules ou de publications, les modèles de fondation apprennent le « langage » de la biologie. Nous les choisissons, les adaptons à vos données et les intégrons à vos analyses.
-
Protéines
Modèles de langage protéique
Représenter des séquences protéiques, prédire l’effet de mutations, la structure ou la fonction, et guider la conception de protéines et de peptides.
-
ADN / génomes
Modèles génomiques
Annoter des génomes, prédire des éléments régulateurs, des sites d’épissage et des sites de fixation de facteurs de transcription, et estimer l’impact de variants non codants sur l’expression des gènes, à partir de la seule séquence d’ADN.
-
Single-cell
Modèles de fondation cellulaires
Annoter les types cellulaires, intégrer des jeux de données et explorer l’effet de perturbations à partir des profils d’expression, toujours en comparaison avec des modèles simples.
-
Texte / littérature
Grands modèles de langage (LLM)
Extraire des informations de la littérature et de comptes rendus, structurer des métadonnées, construire des assistants qui répondent à partir de vos propres documents.
Ce que nous pouvons faire
- EMBEDReprésentations vectorielles
Convertir vos séquences, vos cellules ou vos textes en vecteurs numériques (embeddings), directement utilisables par vos modèles d’analyse.
- TUNEFine-tuning
Spécialiser un modèle pré-entraîné sur vos données et votre question, avec peu d’exemples annotés.
- RAGAssistants sur vos documents
Des LLM qui répondent en s’appuyant sur vos protocoles, rapports ou publications, en citant leurs sources.
- LOCALDéploiement maîtrisé
Des modèles open source déployés sur nos serveurs, chez notre hébergeur en France ou sur les vôtres, sans jamais envoyer vos données à un service d’IA externe.
// 03 Pipeline
De vos données à des prédictions explicables
-
1. Vos données
- Omiques : ADN, ARN, protéines
- Cliniques et contextuelles
- Contrôlées et harmonisées
-
2. Le modèle
- Machine learning ou deep learning
- Conçu ou adapté par fine-tuning
- Validé sur des données indépendantes
-
3. Le résultat
- Prédictions et scores
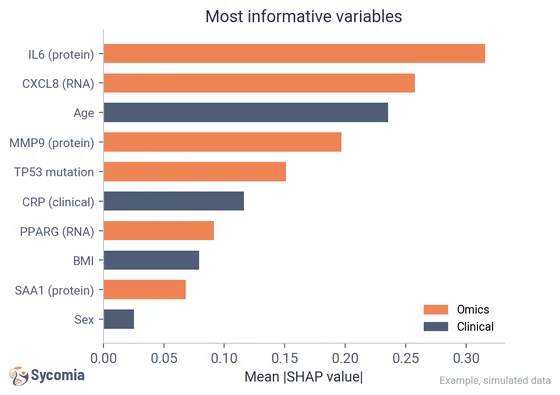
- Variables qui comptent
- Un rapport détaillé
$ sycomia-train --data omics+clinical --model neural-net --early-stopping
[data]   412 samples · 18 734 features · 2 classes
[split]  train 264 · validation 66 · test 82
[epoch 1] loss 0.68 · val_loss 0.71 · val_AUC 0.71
[epoch 2] loss 0.52 · val_loss 0.56 · val_AUC 0.80
[epoch 3] loss 0.43 · val_loss 0.48 · val_AUC 0.85
[epoch 4] loss 0.37 · val_loss 0.43 · val_AUC 0.88
[epoch 5] loss 0.33 · val_loss 0.41 · val_AUC 0.90
[epoch 6] loss 0.30 · val_loss 0.42 · val_AUC 0.89
[epoch 7] loss 0.28 · val_loss 0.44 · val_AUC 0.88
[epoch 8] loss 0.26 · val_loss 0.47 · val_AUC 0.87
[early stop] best epoch 5 · val_AUC 0.90
[baseline] elastic net · test AUC 0.86
[test]   evaluated once · AUC 0.91 [0.84, 0.96]
✓ Modèle validé : prêt à être interprété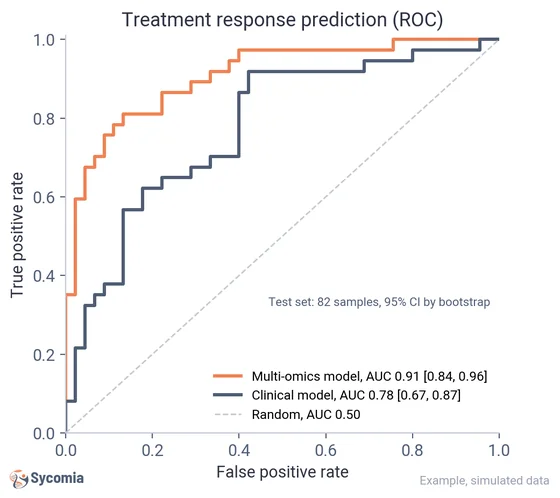
// 04 Méthode
Comment nous travaillons avec vous
Un bon modèle commence par des données propres et une question claire. Nous construisons le modèle adapté à votre problème, nous l’entraînons ou l’adaptons à vos données, et nous rendons ses décisions interprétables.
- MOD.01
Le bon modèle pour vos données
Le modèle est choisi selon la taille et la nature de vos données, des modèles linéaires au deep learning : le plus simple qui répond au mieux à la question.
- MOD.02
Validation rigoureuse
Validation croisée imbriquée, cohortes externes quand elles existent, comparaison avec des modèles simples et aucune fuite de données entre entraînement et test.
- MOD.03
Fine-tuning sur vos données
Adaptation de modèles pré-entraînés à vos propres données pour gagner en précision et en pertinence, tout en réduisant le temps et les ressources d’entraînement.
- MOD.04
Data engineering
Des pipelines automatisés pour collecter, traiter et gérer vos données en toute sécurité, avec qualité, cohérence et traçabilité de la source au modèle.
Questions fréquentes
Une autre question sur votre projet ? Écrivez-nous, un expert vous répond.
Nous contacterUtilisez-vous des LLM et des modèles de fondation ?
Oui. Nous utilisons et adaptons des modèles de fondation pour les protéines, les génomes et le single-cell, ainsi que des LLM pour la littérature et vos documents. Les modèles open source sont déployés sur nos serveurs, chez notre hébergeur en France ou sur les vôtres, sans jamais envoyer vos données à un service d’IA externe.
Quelles données peuvent servir à construire un modèle ?
Des données omiques (ADN, ARN, protéomique), cliniques et contextuelles. Nous vous aidons à évaluer si vos données sont adaptées à votre question avant de construire un modèle.
Pouvez-vous entraîner un modèle sur nos propres données ?
Oui. Nous pouvons développer un modèle à partir de zéro ou adapter un modèle pré-entraîné à vos données par fine-tuning.
Avec quels secteurs travaillez-vous ?
La santé, la recherche académique et industrielle, et l’agroalimentaire.
Mes données restent-elles confidentielles ?
Oui. Nous signons un NDA sur simple demande, avant tout échange de données. Vos données sont traitées sur nos propres serveurs, les données cliniques sont hébergées en France chez un hébergeur de données de santé certifié (HDS), et vos données sont effacées dans les 30 jours suivant la fin du projet, ou plus tôt à votre demande, conformément au RGPD.
Services associés
Parlons de votre projet d’IA
Parlez-nous de votre question biologique et de vos données : nous vous aidons à évaluer ce que l’IA peut apporter et à concevoir le bon modèle.